Problem
İş sorusu, sahtekârlığın hangi segmentlerde yoğunlaştığı ve operasyon ekibinin sınırlı inceleme kapasitesine nasıl öncelik vereceğidir.
Teknik vaka çalışması
IEEE-CIS verileri üzerinde BigQuery, dbt, LightGBM ve FastAPI ile geliştirilen uçtan uca sahtekârlık analitiği platformu. Yönetici ve analist incelemesi için yayımlanan panoda zaman bazlı doğrulama esastır.
Teknik açıklamalar Türkçeye çevrilmiştir. Sonuç metriklerinin ölçüm koşulları, başarısız denemeler ve kaynak bağlantıları özgün proje kanıtlarıyla aynı kapsamda korunur.
Hızlı teknik inceleme
İş sorusu, sahtekârlığın hangi segmentlerde yoğunlaştığı ve operasyon ekibinin sınırlı inceleme kapasitesine nasıl öncelik vereceğidir.
Veri hattı Kaggle CSV dosyalarıyla başlar; DuckDB ve BigQuery üzerinden ilerler, ardından dbt veri martları ve FastAPI raporlama katmanıyla yönetici gösterge panelini yayımlar.
590,540 işlem
Kategorik sütunlar LightGBM modeline ilk görülme sırasına göre numaralanmış tamsayı kodları olarak verildiğinden ağaçlar keyfî kategori sıralamasında bölünür. Depo, henüz etkisi ölçülmemiş bu sınırlamayı açıkça belirtir; doğal kategorik temsile…
Kategorik sütunlar LightGBM modeline ilk görülme sırasına göre numaralanmış tamsayı kodları olarak verildiğinden ağaçlar keyfî kategori sıralamasında bölünür. Depo, henüz etkisi ölçülmemiş bu sınırlamayı açıkça belirtir; doğal kategorik temsile geçiş bütün raporlanan metrikleri değiştirir. TransactionDT bir takvim tarihi değil, geçen süre ofsetidir. Net fayda grafiği de açıkça belirtilen varsayımlara (örneğin yanlış pozitif başına $5.00 inceleme maliyeti) dayanır; dolayısıyla gerçek tasarrufu tahmin etmek yerine bu varsayımlar altında eşikleri karşılaştırır.
Kaynaklarda yayımlanmış teknik kanıtlar kullanılmıştır. Ölçüm koşulları için tam vaka çalışmasını inceleyin.
Kanıta dayalı görsel inceleme
Gerçek proje ekran görüntüleri ve kaynak figürleri, kaynaklarıyla birlikte sunulur.
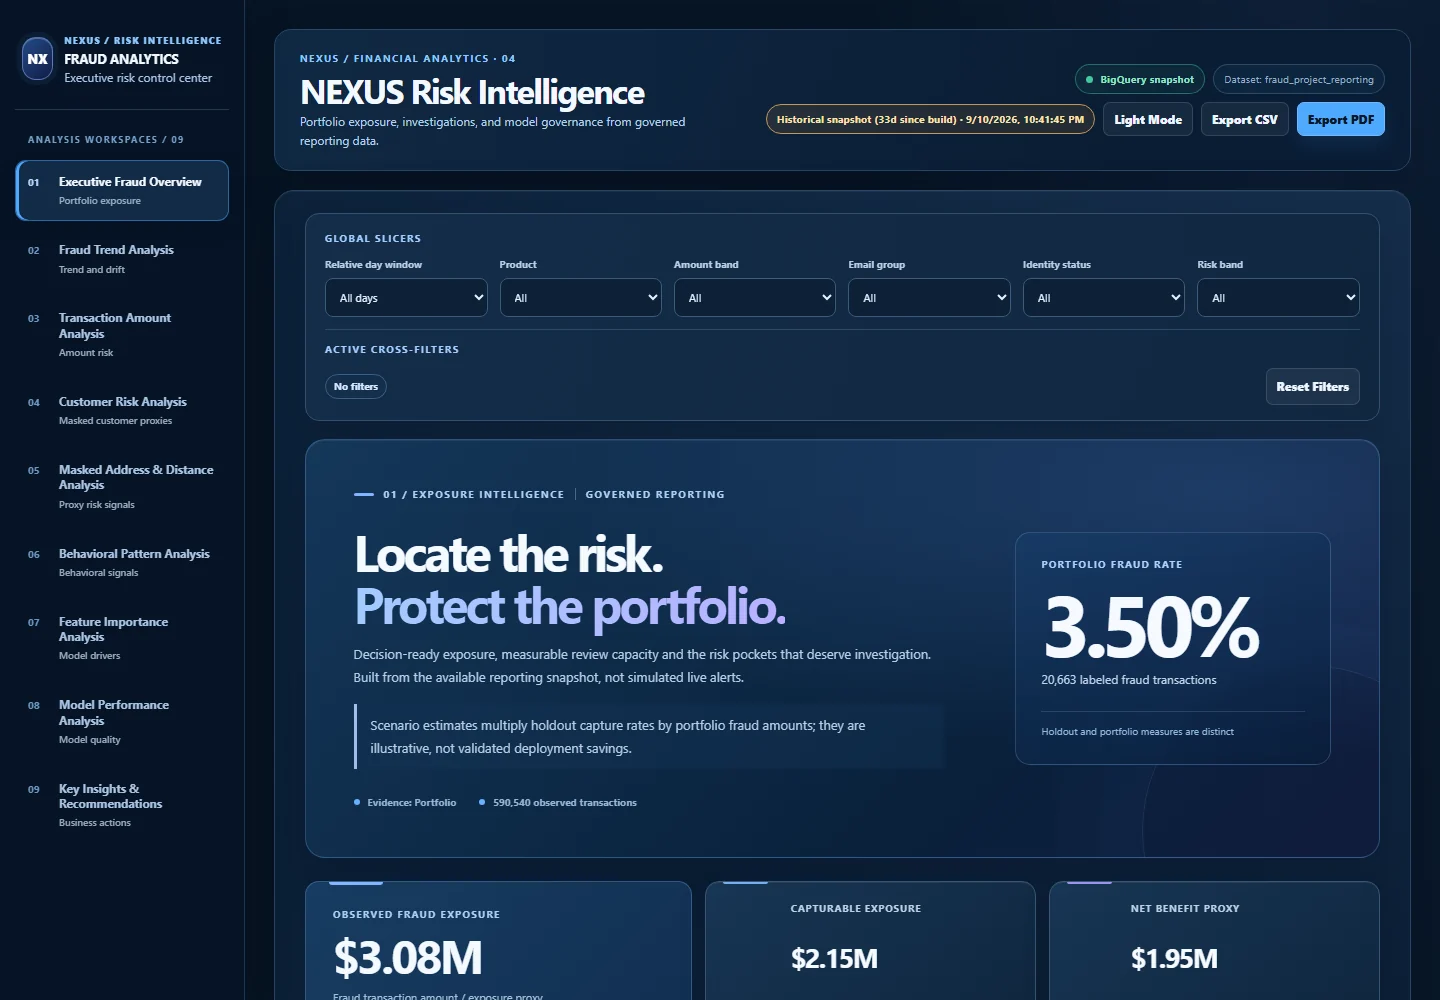
Tarihli demo ekran görüntüsü
2026-10-14 tarihli herkese açık demo görüntüsüdür; demonun şu anda erişilebilir olduğunu kanıtlamaz.
Yayımlanmış kaynağı aç590,540 işlem
126 dbt veri testi + 23 Python sözleşme testi
0.9134 ROC-AUC / 0.5354 ortalama kesinlik
En yüksek 5% bant sahtekârlığın 58.32% bölümünü yakalar
High bant: ayrılmış testte 30.34%, eğitim içinde 44.59%
Puanlar tasarım gereği kalibre edilmemiştir: ortalamada 5.22x fazla tahmin
Proje kanıtları
Son doğrulama 2026-10-05
Problem ve yaklaşım
İş sorusu, sahtekârlığın hangi segmentlerde yoğunlaştığı ve operasyon ekibinin sınırlı inceleme kapasitesine nasıl öncelik vereceğidir.
Veri hattı Kaggle CSV dosyalarıyla başlar; DuckDB ve BigQuery üzerinden ilerler, ardından dbt veri martları ve FastAPI raporlama katmanıyla yönetici gösterge panelini yayımlar.
LightGBM sınıflandırıcısı zamana dayalı ayrılmış test kümesinde doğrulanır ve işlemleri otomatik reddeden bir sistem olarak değil, uzman incelemesine öncelik veren bir katman olarak kullanılır.
Risk bantlarının kalitesi, modelin eğitildiği bölümde değil, eğitim dışında tutulan 118,108 işlemde raporlanır. Model zaman ekseninin ilk 80% bölümünde eğitilip tüm satırlara puan verdiği için bu bölümün beşte dördü eğitim içi gözlemlerden oluşur ve bant sonuçlarını olduğundan iyi gösterir: High bandı burada 44.59%, eğitim dışında tutulan işlemlerde ise 30.34% düzeyindedir. Gösterge paneli farkı model lehine kapatmak yerine her bant için ayrı açıklar. Veri hattının belirlenimliliği de varsayım olarak değil ölçümle doğrulanmıştır: 1 Eylül 2026 yeniden eğitimi, model kayıt sistemindeki 24 alanın 23 tanesini bayt düzeyinde aynı üretmiş; yalnızca eğitim tarihi değişmiştir.
Model puanı bir olasılık değil, sıralama ölçüsüdür; proje bu ayrımı varsaymak yerine ölçer. Dengeli sınıf ağırlıkları 3.5% oranındaki pozitif sınıfı yaklaşık 28:1 oranında ağırlaştırır. Bu sıralama gücünü artırırken olasılık ölçeğini bozar: ayrılmış test kümesinde ortalama puan 17.96%, gözlenen sahtekârlık oranı 3.44%, yani 5.22x fazla tahmindir. Brier skoru 0.0636 ile sabit taban oranı tahmininin 0.0332 sonucundan kötüdür. Alt kullanım alanlarının tamamı sıralamaya dayandığından bu olasılık sapması onları doğrudan değiştirmez; yine de güvenilirlik eğrisi yayımlanır ve sınırlama incelenebilir.
Eylül 2026 incelemesinde dört ölçüm hatası bulunup düzeltildi. İnceleme kuyruğu, değerlendirilen işlemin etiketini aynı varlığın sahtekârlık geçmişine katıyordu. İki boyutlu filtreler segment oranlarını risk sıralamalı kuyruktan okuyarak 100% sahtekârlık oranı gösteriyordu. Altı noktada gözlenen sahtekârlık tutarı yerine her sahtekârlık etiketi için sabit $120 kullanılıyordu. Net fayda grafiği, tespit edilen ve kaçırılan sahtekârlığı farklı ölçeklerde fiyatlayan açıklanmamış iki sabite dayanıyordu. Düzeltilen davranış şimdi 23 Python sözleşme testiyle korunuyor.
Kategorik sütunlar LightGBM modeline ilk görülme sırasına göre numaralanmış tamsayı kodları olarak verildiğinden ağaçlar keyfî kategori sıralamasında bölünür. Depo, henüz etkisi ölçülmemiş bu sınırlamayı açıkça belirtir; doğal kategorik temsile geçiş bütün raporlanan metrikleri değiştirir. TransactionDT bir takvim tarihi değil, geçen süre ofsetidir. Net fayda grafiği de açıkça belirtilen varsayımlara (örneğin yanlış pozitif başına $5.00 inceleme maliyeti) dayanır; dolayısıyla gerçek tasarrufu tahmin etmek yerine bu varsayımlar altında eşikleri karşılaştırır.
Raporlama yanıtları önceden hesaplanıp depoya kaydedilmiş anlık görüntüler üzerinden diskten sunulur. Böylece panel yaklaşık 0.4 saniyede yanıt verir ve istek anında veri ambarına sorgu göndermez.
Çalışma; analitik mühendisliği, makine öğrenmesi değerlendirmesi ve uzman inceleme kuyruğu tasarımını ayrı depolara dağıtmak yerine aynı portföy deneyiminde birleştirir.
Mimari ve analiz
Test ve doğrulama
Operasyonel değer
Nasıl incelenir