Problem
60 saniyelik emir/işlem geçmişi ve 600 saniyelik piyasa anlık görüntüleri içeren 1.26M anonim piyasa penceresi için kısa vadeli getiri tahmini yapılır. Puan, bütün test kümesindeki kosinüs benzerliğiyle hesaplanır. Sembol sütunu olmadığı için enstrümanlar arası tarihçe bulunmaz; her örnek kendi başına yeterli olmalıdır.
Mimari
Feather dosyaları, tek seferde okumanın gerektirdiği 11.53 GB yerine tepe belleği 7.92 GB düzeyinde tutan sütun grubu dönüştürücüsüyle işlenir. BigQuery içinde örnek başına 292 özellik oluşturulup modeller yerel ortamda eğitilir. FastAPI, eğitim paketini gerektirmeden yüklenen bir model çıktısıyla servis verir; Streamlit paneli de arkada çalışan veri hattı olmadan depoya kaydedilmiş sonuçlardan beslenir.
Doğrulama
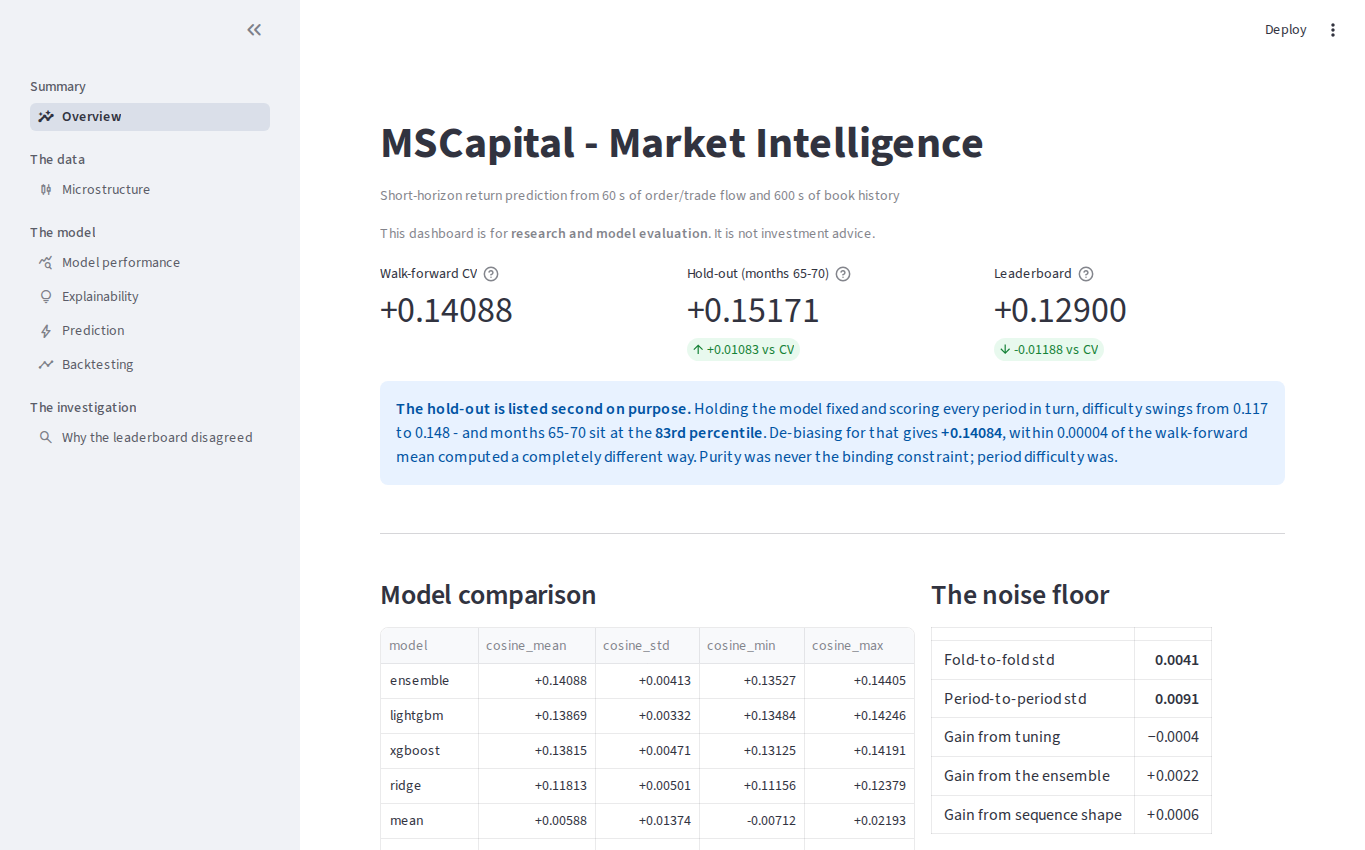
Birbirini izleyen örneklerin 60 saniyelik pencereleri çakışabileceğinden rastgele ayrım veri sızıntısı yaratabilir. Bu nedenle genişleyen pencereli ileriye dönük doğrulama ve bir aylık embargo kullanılır. Beş katın ortalama topluluk kosinüs skoru +0.14088, katlar arası standart sapma 0.0041 düzeyindedir. 65-70. aylar tek bir son değerlendirme için hiç kullanılmadan saklanmış ve +0.15171 vermiştir.
İnceleme
Gönderimden önce yanlışlanabilir bir tahmin kaydedildi ve sonuç onu doğrulamadı: 0.143 beklenirken yarışma puanı 0.128 geldi. Yeni gönderim hakkı harcanmadan altı hipotez test edildi. Biri doğrulandı: holdout dönemi zorluk dağılımının 83. yüzdelik dilimindeydi; bu etki giderildiğinde +0.14084 elde edildi ve farklı yöntemle hesaplanan ileriye dönük doğrulama ortalamasından yalnızca 0.00004 ayrıldı. Biri gerçek ama beklenenden küçüktü: spread rejimi dağılımı farkın yaklaşık 14% bölümünü açıklıyordu. En umut verici iki hipotez dâhil dört hipotez yanlışlandı. Geri kalan fark proje lehine kapatılmadan belgelenmiştir.
Ölçüm disiplini
Önceden kaydedilen beş tahminin beşi de gerçekleşenden yüksekti; bu durum beş ayrı hatadan çok ortak bir nedene işaret ediyordu. Korunan ilke şudur: katlar arası gürültüden küçük dahili kazanımlar, hangi modeli seçeceğimize ilişkin kanıttır; yarışma skoruna aynen aktarılacak kazanç değildir. Tahmin vektörü üzerinde sonradan yapılan üç düzeltme de ölçülüp reddedildi: en iyisi aynı veride ayarlandığında +0.0022 kazandırırken tek parametresi örneklem dışında seçildiğinde kazanç yaklaşık sıfıra düştü.
İddia edilmeyen noktalar
Dizi sırası hipotezi, yalnızca yapılan deneyin desteklediği kapsamda ifade edilir. Elle tasarlanmış 18 yol istatistiği +0.0006 kazandırdı; ancak yeni özellikler tek başına 0.0057 alırken sabit ortalama tahmini 0.0059 verdi. Özet özellikler çok az bilgi taşıdığından deney, sinyalsiz bir yolla sinyali iyi özetlemeyen bir gösterim arasında ayrım yapamaz. Daha sonra öğrenilmiş dizi modeli (v1.1.0) denendi: tek başına 0.077 aldı, fakat tablosal modele eklenmesinin yararı gösterilemedi (eşleştirilmiş fark -0.0009; eğitim dışında bırakılan sekiz ayda 95% güven aralığı -0.0104 ile +0.0086). Dolayısıyla hipotez bu kapsamda ne doğrulandı ne de çürütüldü.
İlk sürümden sonra
İlk sürümden sonraki dört deneyin karar kuralı çalıştırmadan önce yazıldı ve her biri geliştirmeyi amaçladığı modele karşı eşleştirilmiş farkla değerlendirildi; hiçbirinin katkısı gösterilemedi: öğrenilmiş dizi modeli (CNN tek başına 0.077, karışım farkı -0.0009), özellik uzayından tahmin edilen rejim (-0.0010; +0.0002 üzerindeki kazançları dışlayacak kadar dar aralık), dört ek topluluk modeli (+0.0017 ancak daha düşük havuzlanmış kosinüs) ve 28 yakın kopya özelliğin kaldırılması (-0.0005). Ayrıca sample_id değerinin eğitimde yalnızca ay ölçeğinde kronolojik olduğu ve testte sıralama taşımadığı bulundu; bu yüzden komşu örneklerden üretilen özellikler eğitimde hesaplanabilirken gerçek puanlamada hesaplanamaz. 16 GB makinede Ridge adımı bellek sınırına takıldığından aynı tahminleri üreten parça parça eğitim uygulanmıştır. Yayımlanan topluluk modelinin genel yarışma skoru değişmeden 0.129 kaldı; model dosyaları Hugging Face üzerinde açıktır.
Yayımlama ve teslim
533 testin hiçbiri canlı BigQuery veya indirilen veri gerektirmez (CatBoost ve PyTorch kurulu değilse ilgili testler atlanır). Her push üzerinde dört CI işi bulunur: lint, tip denetimi ve testler; yalnızca çalışma zamanı bağımlılıklarıyla bütün panel sayfalarının render edilmesi; hafif API imajının Docker derleme ve smoke testi; demo modelini eğitip API imajına HTTP üzerinden istek gönderen uçtan uca test. Servis imajı, tek imajlı eski sürümün 3.48 GB boyutuna karşı 777 MB düzeyindedir. Sentetik veri demosu, kimlik bilgisi gerektirmeden tüm hattı yaklaşık 15 saniyede çalıştırır.
Neden önemli?
Yarışma skoru katılımcı ortancasının altındadır ve proje bunu giriş sayfasında açıkça belirtir. Çalışmanın asıl gösterdiği aktarılabilir beceri; sonucu öğrenmeden önce tahminleri kaydetmek, varsayımı savunmak yerine ölçmek ve sonuç beklentiyle çeliştiğinde de açıkça raporlamaktır.